segunda-feira, março 05, 2007

Construindo um Compilador - Parte 2

Nesta parte vamos ver como se constrói um analisador léxico. Como vimos na parte 1, ele é responsável por reconhecer os itens léxicos no fonte.

Itens léxicos típicos são identificadores de variáveis e rotinas, palavras reservadas, constantes e símbolos. Cada um destes itens se caracteriza por uma seqüência de caracteres que segue uma regra simples (por exemplo, "um identificador deve começar por uma letra e possuir somente letras e números"). Isto recomenda o uso de máquinas de estado para o reconhecer os itens léxicos. Toda vez que o analisador léxico é chamado para reconhecer o próximo item léxico, ele parte de um estado inicial e vai mudando de estado a cada caractere examinado, até reconhecer o item ou detectar uma seqüência inválida de caracteres (um "erro léxico").

Por exemplo, vamos considerar um caso simples, em que os itens léxicos são números inteiros decimais e as operações + e -. De uma forma livre, teríamos o seguinte analisador léxico na linguagem C:

estado = INICIAL;
while (estado != FINAL)
{
c = ProximoCaracter();
switch (estado)
{
case INICIAL:
if (c == EOF)
{
item = EOF;
estado = FINAL;
}
else if (isdigit(c))
estado = NUMERO;
else if (c == '+')
{
item = MAIS;
estado = FINAL;
}
else if (c == '-')
{
item = MENOS;
estado = FINAL;
}
else if (!isspace(c))
{
item = ERRO;
estado = FINAL;
}
break;
case NUMERO:
if (c == EOF)
{
item = NUMERO;
estado = FINAL;
}
if (!isdigit(c))
{
DevolveCaracter(c);
item = NUMERO;
estado = FINAL;
}
}
}

Para não estender mais o código, não estamos guardando o valor do número (o que fica como exercício para o leitor). Reparar que eventualmente o código acima examina um caractere além do final do item e precisa "devolvê-lo". Tipicamente um analisador léxico não precisa guardar estados entre uma chamada e outra nem voltar atrás nos seus passos.

Algumas linguagens possuem idiossincrasias que dificultam o analisador léxico. Por exemplo, algumas versões do FORTRAN permitem colocar espaços no meio de identificadores, criando seqüências de difícil análise como:

DO 10 I = 1, 10

Somente ao encontrar a vírgula o analisador léxico descobre que os itens léxicos são <DO> <10> <I> <=> (comando DO) ao invés de <DO10I> <=> (o que seria um comando de atribuição).

O analisador léxico é também responsável por desprezar os comentários nos fontes.

No caso de identificadores e palavras reservadas, a máquina de estado apenas isola a seqüência de caracteres. O analisador léxico precisa também identificar o item.

No caso das palavras reservadas, normalmente existe uma tabela ou lista onde a seqüência isolada deve ser procurada. Uma forma simples, mas ineficiente, é fazer uma busca seqüencial. Uma forma mais inteligente é ordenar previamente a lista e fazer uma busca binária.

Uma forma ainda melhor é usar hashing. No hashing, calcula-se um número (hash) a partir da seqüência de caracteres e usa-se este número como índice para a tabela.

O principal problema com o hashing é que várias seqüências podem gerar o mesmo hash (gerando uma colisão). Ao inserir um item numa tabela de hash, se a posição já estiver ocupada é preciso fazer uma lista ligada na posição para colocar o novo item. Ao fazer uma busca, é preciso fazer uma busca seqüencial nesta lista ligada.

Uma opção para diminuir as colisões é aumentar a faixa de valores para o hash, porém isto leva ao desperdício de memória. No caso das palavras reservadas, a lista é constante, o que permite escolher previamente uma função de hash que evite colisões. Por exemplo, pode-se criar uma função parametrizada e deixar um computador procurando exaustivamente os parâmetros que otimizem a função de hash.

Uma vez determinado que uma seqüência não é uma palavra reservada, o analisador léxico deve tentar descobrir o tipo de identificador. Isto é feito procurando a seqüência em tabelas de nomes de variáveis, funções, etc construída pelo analisador semântico. Estas tabelas podem usar o hashing para otimizar a busca. Um truque simples mas eficaz consiste ao encontrar um item na lista ligada da tabela de hash mover este item para o início da lista. Isto faz com que a lista automaticamente se ordene em função do uso dos itens.

Em algumas linguagens é permitido usar um identificador que ainda não foi declarado e portanto tem tipo ignorado. Isto não afeta o analisador léxico porém complica o analisador sintático e pode obrigar o analisador semântico a segurar a geração do código objeto até que o identificador seja declarado.

Na próxima parte vamos ver o coração do compilador, o analisador sintático.

terça-feira, fevereiro 27, 2007

Construindo um Compilador - Parte 1

Esta série de posts foi instigada por uma mensagem no grupo C++ Brasil.

Minha primeira experiência em construir um compilador foi na faculdade. Lembro vagamente que era um compilador que gerava um programa para uma calculadora Texas a partir de uma linguagem parecida com Basic.

Recem formado, tive a oportunidade de participar de uma série de cursos na Scopus, não relacionados diretamente a projetos. Um deles foi A Construção de Um Compilador, lecionado pelo professor Valdemar Setzer. O material para este curso foi uma versão preliminar de um livro do próprio Setzer (em conjunto com Inês S Homem de Melo), que posteriormente viria a ser publicado pela Editora Campus.

Vários anos depois, tive a oportunidade de utilizar na prática estes conhecimentos, ao participar da definição e desenvolvimento de uma linguagem de script para o programa de comunicação Zapt da Humana Informática.

A forma de implementar um compilador que vou apresentar nestes posts se baseia diretamente no livro do Setzer. Obviamente vou ser bastante superficial nestes posts (o livro tem mais de 300 páginas).


O Que é Um Compilador?

Podemos dizer que um compilador é um programa que traduz um programa escrito em uma linguagem (linguagem fonte) para uma outra linguagem (linguagem objeto). Tipicamente a linguagem fonte é uma linguagem de alto nível e a linguagem objeto é o código de máquina.

Um parente próximo do compilador é o interpretador, que ao invés de gerar o programa em linguagem objeto ele o executa.

Um compilador pode não converter diretamente a linguagem fonte na linguagem objeto, ele pode ser composto de vários passos utilizando linguagens intermediárias. Um exemplo típico são compiladores que usam linguagem Assembly como uma linguagem intermediária.

Definindo Uma Linguagem

Tipicamente a definição de uma linguagem começa com os itens básicos para a escrita de programas: palavras reservadas, símbolos especiais, constantes e identificadores. Estes itens são denominados itens léxicos.

A forma como estes itens léxicos são combinados para gerar declarações, expressões e comandos em geral de uma linguagem é definida pela gramática da linguagem. Existem várias formas de se definir uma linguagem, algumas mais formais (como a notação BNF) e outras menso. Nestes posts vou usar os grafos sintáticos para descrever a gramática.

A definição da linguagem pode facilitar ou complicar a sua compilação. O método que será abordado é mais adequado para lingugens "bem comportadas".

Estrutura de Um Compilador

Tradicionalmente se divide o compilador em três grandes partes:
  • Analisador Léxico: reconhece no fonte os itens léxicos
  • Analisador Sintático: verifica se a sequência de itens léxicos contida no fonte está de acordo com a gramática da linguagem e reconhece as várias construções.
  • Analisador Semântico: Gera o código objeto para as construções reconhecidas pala analisador sintático.
No próximo post veremos como fazer um analisador léxico.

quarta-feira, fevereiro 21, 2007

Programação Assembly no ARM - Parte IV

Nesta parte vamos ver as instruções de acesso à memória. Como vimos na parte anterior, as instruções lógicas e aritméticas do ARM trabalham com operandos nos registradores. As instruções de acesso à memória no ARM são primordialmente a carga de um registrador em uma posição de memória e o armazenamento do conteúdo do registrador em uma posição da memória, conforme dita a filosofia RISC.

Estas instruções, denominadas de Single Data Transfer, são codificadas conforme a figura abaixo:

Note que embora sejam apenas duas instruções assembly, LDR e STR, existem uma grande quantidade de opções. Como sempre, o opcode contém uma condição. O bit L diferencia a instrução de Load (carga do registrador a partir da memória) da instrução de Store (armazenamento na memória do conteudo do registrador). Rd indica o registrador que receberá o valor lido (LDR) ou que contém o valor a ser armazenado (STR). O bit B indica se estamos manipulando um word (32 bits) ou byte (8 bits); existem instruções separadas para manipular valores de 16 bits (half-words). O resto dos campos do opcode determinam o endereço da posição de memória a ser manipulada.

Este endereço é determinado por duas partes: a base (que fica no registrador Rn) e o offset (que, conforme o bit I, pode ser um valor imediato de 12 bits ou o conteúdo de um registrador deslocado). O deslocamento do registrador usado para o offset é determinado de forma semelhante ao usado para o valor imediato nas instruções lógicas e aritméticas. O bit U indica se o offset deve ser somado ou subtraído da base.

O bit P determina se a combinação da base com o offset deve ser feita antes (pré-indexação) ou depois (pós-indexação) do acesso à memória. O bit W permite atualizar o registrador base com o valor final do endereço. Quando se especifica a pós-indexação, o ARM atualiza sempre o registrador base, para não alterá-lo deve-se colocar um offset de zero. Na prática, isto significa:
  • P = 0, W = 0: normalmente tratado pelo ARM como P = 0, W = 1. (para ser preciso, no modo privelegiado em um processador com hardware de gerenciamento de memória esta combinação faz com que o endereço seja tratado como um endereço de usuário ao invés de endereço de sistema).
  • P = 1, W = 0: combina base e offset para determinar o endereço, o registrador base fica inalterado. Útil, por exemplo, para acessar um item de um vetor (base é o endereço inicial e o offset é o deslocamento em relação ao início).
  • P = 0, W = 1: usa somente a base para determinar o endereço, após o acesso à memória a base é atualizada com a combinação da base com o offset. Permite implementar em uma única instrução a construção *p++ do C (acessa a posição apontada pelo registrador base e o avança para o próximo item).
  • P = 1, W = 1: combina base e offset para determinar o endereço, o registrador base é atualizado para o endereço usado. Permite implementar em uma única instrução a construção *++p do C (avança o registrador base para o próximo item e o acessa).
A codificação da instrução em Assembly é a seguinte:

LDR{cond}{B} Rd,<endereço>
STR{cond}{B} Rd,<endereço>

Onde B indica que é um acesso a byte.

<endereço> pode ser
  • uma expressão, que resulta em um endereço. O Assembler tenta montar uma instrução que combine um offset ao PC para obter este endereço, se não conseguir gerará um erro. Esta forma é útil para carregar em registradores constantes que estão armazenadas junto ao código.

  • uma especificação de endereçamento pré-indexado (combina base e offset antes de acessar a memória):

    • [Rn]

    • [Rn,#expressão] {!}

    • [Rn,{+/-}Rm{,<shift>}] {!}

    • A presença de ! indica que o registrador base deve ser atualizado (W = 1).

  • uma especificação de endereçamento pós-indexado (combina base e offset depois de acessar a memória):
    • [Rn],#expressão

    • [Rn],{+/-}Rm{,}

    • nestes casos o registrador base é sempre atualizado.
Alguns exemplos

; coloca valores conhecidos em R1 e R2
MOV R1,#0
MOV R2,#4

; coloca em R0 o conteúdo da posição 0 da memória
LDR R0,[R1]

; coloca em R0 o conteúdo da posição 4 da memória
LDR R0,[R1,R2]

; coloca em R0 o conteúdo da posição 32 da memória
LDR R0,[R1,R2,LSL #3]

; idem
LDR R0,[R1+#32]

; coloca em R0 o conteúdo da posição 4 da memória
; R1 passa a ser 4
LDR R0,[R1,R2]!
; coloca em R0 o conteúdo da posição 4 da memória
; R1 passa a ser 8
LDR R0,[R1],R2

Reparar que não é possível especificar diretamente um endereço qualquer da memória, pois o offset imediato tem 12 bits e um endereço tem 32 bits. Além disso, já vimos que as instruções lógicas e aritméticas são limitadas quanto aos valores imediatos que podem ser usados. Para carregar em um registrador um endereço ou constante qualquer, é preciso armazená-lo em memória em uma posição que possa ser acessada por um LDR. Isto torna frequente a presença de constantes no meio do código:

...
LDR Rd,X ; usa endereçamento relativo ao PC
...
X .long valor ; em algum lugar próximo

Para facilitar isto, o Assembler permite a seguinte construção:

LDR Rd,=valor

Se possível, o assembler gera uma instrução MOV ou MVN para carregar o valor no registrador. Se isto não for possível, o assembler coloca a constante em um trecho próximo e gera uma instrução LDR usando endereçamento relativo ao PC.

Outras Instruções de Acesso à Memória

As instruções LDRH, LDRSH e STRH permitem carregar e armazenar valores de 16 bits (half word). A instrução LDRSH faz a "extensão do sinal", isto é, preenche os 16 bits mais significativos do registrador com o bit mais significativo do valor de 16 bits, de forma a manter o sinal do valor. O mesmo opcode permite também carregar em um registrador um valor de 8 bits com extensão de sinal (LDRSB). Estas instruções oferecem os mesmos recursos de endereçamento que LDR e STR.

As instruções LDM e STM (Block Data Transfer) permitem carregar ou armazenar um conjunto de registradores em posições contiguas de memória. A codificação destas instruções é apresentada abaixo:


Register list possui 16 bits, um para cada registrador. Os bits com 1 indicam os registradores a serem transferidos. O endereço inicial é obtido a partir de um registrador, que será automaticamente incrementado ou decrementado, antes ou depois de transferir cada registrador. O registrador utilizado pode ou não ser atualizado ao final da transferência.

A codificação em assembly destas instruções é:

LDM{cond}<fd|ed|fa|ea|ia|ib|da|db> Rn{!},<rlist>
STM{cond}<fd|ed|fa|ea|ia|ib|da|db> Rn{!},<rlist>

Onde
  • {cond} é a condição em que a instrução será executada.

  • FD, ED,..DB determinam os bits P e U. FD, ED, FA e EA são (respectivamente) idênticos a IA, IB, DA e DB; os primeiros são utilizados para documentar quando os registradores estão sendo transferidos para uma pilha.

  • ! indica que o registrador Rn deve ser atualizado ao final
Alguns exemplos:

; salva todos os registradores em posições
; consecutivas a partir da apontada por R0
STMIA R0,{R0-R15}

; empilha os registradores (exceto R15/PC)
STMFD SP!,{R0-R15}

; Salva na pilha os registradores R1, R3 e R5
STMFD SP!,{R1, R3, R5}

; desempilha os registradores
LDMED SP!,{R0-R14}

terça-feira, fevereiro 06, 2007

Programação Assembly no ARM - Parte III

Continuando o nosso estudo das instruções, vamos examinar com mais detalhes o grupo de instruções de Data Processing. Este grupo contém as instruções aritméticas, lógicas e de movimentação. Estas instruções realizam uma operação sobre um ou dois operandos (Op1 e Op2) e colocam o resultado em um registrador (Rd) ou nos flags.

A figura abaixo mostra os vários campos do opcode destas instruções:

Na parte II nós já vimos os campos Cond e S. O campo Opcode determina a operação que será executada:

Opcode mne ação
0000 AND Rd := Op1 AND Op2
0001 EOR Rd := Op1 XOR Op2
0010 SUB Rd := Op1 - Op2
0011 RSB Rd := Op2 - Op1
0100 ADD Rd := Op1 + Op2
0101 ADC Rd := Op1 + Op2 + C
0110 SBC Rd := Op1 - Op2 + C - 1
0111 RSC Rd := Op2 - Op1 + C - 1
1000 TST posiciona flags conforme Op1 AND Op2
1001 TEQ posiciona flags conforme Op1 XOR Op2
1010 CMP posiciona flags conforme Op1 - Op2
1011 CMN posiciona flags conforme Op1 + Op2
1100 ORR Rd := Op1 OR Op2
1101 MOV Rd := Op2
1110 BIC Rd := Op1 AND NOT Op2
1111 MVN Rd := NOT Op2

Portanto o campo Rd determina o registrador (R0 a R15) que será o destino do resultado da operação. As instruções TST, TEQ, CMP e CMN ignoram este campo. Como o único resultado destas operações é o posicionamento dos flags, o bit S é sempre forçado pelos assemblers.

Op1 é sempre um registrador e é definido por Rn; as instruções MOV e MVN ignoram o campo Rn.

Existem duas opções para a codificação do campo Operand 2.

1. Se I for 0, o segundo operando é um registrador, cujo conteúdo pode ser deslocado:

Este deslocamento pode de quatro formas:
  • Lógico para a esquerda (LSL): desloca para a esquerda introduzindo zeros à direita
  • Lógico para a direita (LSR): desloca para a direita introduzindo zeros à esquerda
  • Aritmético para a direita (ASR): desloca para a direita repetindo o bit mais significativo na esquerda
  • Rotação para a direita (ROR): desloca para a direita, introduzindo na esquerda os bits que 'saem' à direita
Além disso, o número de bits a deslocar pode ser especificado diretamente no opcode (0 a 15) ou ser obtido de um outro registrador (neste caso é considerado o byte meno significativo do registrador, permitindo deslocamentos de 0 a 255 bits).

2. Se I for 1, o segundo operando é um valor imediato (codificado na própria instrução):
O valor de 8 bits (Imm) contido na instrução é expandido para 32 bits colocando-se zeros à esquerda e em seguida rodado para a direita o dobro de vezes do especificado em Rotate. Como Rotate tem 4 bits, isto significa que o valor pode ser rodado 0, 2, 4, 8 .. 30 bits para a direita. Embora esta codificação permita colocar um grande variedade de constantes na instrução, uma quantidade ainda maior não tem como ser codificada. Neste caso o valor precisa ser armazenado em uma posição da memória e carregado para um registrador antes de executar a operação. Por exemplo, as constantes 0, 1, 0x100 e 0x110 podem ser codificadas mas 0x101 não.

Vejamos agora como escrever estas instruções na linguagem Assembly.

MOV e MVN
{cond}{S} Rd,

CMP,CMN,TEQ,TST
{cond} Rn,

AND,EOR,SUB,RSB,ADD,ADC,SBC,RSC,ORR,BIC
{cond}{S} Rd,Rn,

onde

é o mnemônico da instrução
{cond} é a condição (opcional)
{S} indica que pode ser acrescentado S para a instrução afetar os flags
pode ser Rm{,} ou <#expressão>
pode ser Rs ou #expressão
é ASL, LSL, LSR, ASR ou ROR
Rd, Rn, Rm e Rs são os registradores R0 a R15

Quando Op2 for especificado com #expressão, o assembler tentará codificá-lo em um valor imediato. Se não conseguir, acusará erro.

Vejamos se alguns exemplos esclarecem um pouco:

MOV R1,#100 ; coloca 100 em R1
MOVS R1,R0 ; coloca o conteúdo de R0 em R1, atualiza os flags
MOV R1,R0 ASL 5 ; coloca R0 * 32 em R1
MOV R1, R0 ROR R2 ; coloca em R1 o valor de R0 rodado para a direita de R2 bits
ADD R2,R1,R0 ; soma R1 a R0 e coloca o resultado em R2
ADD R1,R1,#1 ; incrementa R1
CMP R1,R2 ; compara R1 a R2, flags posicionados cf R1-R2
TST R1,#0x80000000 ; testa o bit mais significativo de R1
BIC R1,R1,#1 ; zera o bit menos significativo de R1

No próximo post da série vamos ver como acessar dados na memória. Até lá!

sexta-feira, fevereiro 02, 2007

Programação Assembly no ARM - Parte II

Nesta segunda parte vamos começar a falar sobre as instruções do ARM. Todas as instruções do ARM ocupam exatamente um word de 32 bits:

O primeiro ponto a reparar é como a codificação é uniforme em todas as instruções. Isto visa simplificar o hardware de decodificação das instruções e faz parte da filosofia RISC.

Um segundo ponto interessante é o campo Cond que aparece em todas as instruções. Este campo determina como devem estar os flags para a instrução ser executada. Na maioria dos processadores apenas as instruções de desvio dependem dos flags, no ARM todas as instruções são condicionais! A tabela abaixo mostra as condições disponíveis:

O sufixo na tabela acima deve ser acrescentado ao mnemônico da instrução a ser afetada; o sufixo AL pode ser omnitido (e normalmente é). Este sufixo fica obvio no caso de uma instrução de desvio: B (ou BAL) é um desvio incondicional, BEQ é um desvio se igual. As coisas ficam um pouco mais confusas com outras instruções, por exemplo LDREQ é uma instrução de Load Register que só é executado quando o flag Z estiver ligado.

Ainda na codificação das instruções, repare no bit S nas três primeiras linhas. Estas linhas codificam as instruções aritméticas, lógicas e de movimentação. O bit S indica se a instrução vai ou não afetar os flags. No Assembly, isto é feito acrescentando o sufixo S no mnemônico quando se deseja afetar os flags. Por exemplo, uma instrução AND não afeta os flags, mas ANDS afeta (é claro de ANDEQS afeta os flags somente quando for executada, o que só ocorre quando o flag Z está ligado).

E quais são as instruções disponíveis? A figura abaixo tem a lista completa:

Para podermos entender estas instruções é necessário conhecer primeiro como são codificados os operandos, o que veremos no próximo post.

quinta-feira, fevereiro 01, 2007

Programação Assembly no ARM - Parte I

Atualmente é bastante raro eu programar em Assembly. Entretanto, pela segunda vez estou tendo que alterar um módulo de iniciação para um sistema embarcado utilizando um processador com arquitetura ARM. Não sei se é a falta de prática ou as pecularidades do ARM, mas nos dois casos suei muito para fazer as poucas linhas necessárias. Para tentar consolidar o meu aprendizado, resolvi fazer uma pequena serie de posts sobre o assunto.

O que é a arquitetura ARM?

Eu diria que a arquitetura ARM (que já foi chamadado de "Advanced RISC Machine" e "Acorn RISC Machine") é uma especificação dos registradores e instruções de máquina de um processador de 32 bits baseado na filosofia RISC (a Wikipedia tem uma definição mais longa).

Na verdade existem várias versões desta especificação, a que vou tratar aqui é chamada de ARM7TDMI. Esta especificação inclui um modo com instruções de 16 bits (Thumb) que vou ignorar nestes posts. A empresa responsável pelo ARM7TDMI licencia a sua implemantação para inclusão em vários microcontroladores, como os da Atmel e ST Microeletronics.

A descrição do ARM7DMI em formato pdf pode ser encontrada aqui.

São características RISC do ARM:
  • As instruções são todas codificadas da mesma forma, ocupando sempre 32 bits
  • Existem vários registradores e as instruções aceitam qualquer um deles como operando
  • A memória é usada como operando somente para movimentação; operações aritméticas e lógicas usam registradores e constantes como operando
  • A maioria das instruções são executadas em um único ciclo
Uma vez que RISC quer dizer "Computador com Conjunto de Instruções Restrito", muitos esperam que um processador RISC tenha poucas instruções. Na verdade, depende de como se conta as instruções. Existem 34 instruções básicas, porém elas podem ser condicionais e a maioria suporta diversos tipos de operando e modos de endereçamento, gerando um número grande de operações possíveis.

Existem inúmeros Assemblers disponíveis para o ARM, utilizando diversas sintaxes. A sintaxe que eu uso aqui é compatível com o GNU Arm Toolchain.

Os registradores do ARM

O ARM possui 16 registradores de 32 bits, denominados simplesmente de R0 a R15. O registrador R15 é sempre usado como ponteiro para a próxima instrução a executar e pode ser referenciado no Assembly como PC.

A função de chamada de subrotina salva o endereço de retorno no registrador R14, também chamado de link register (LR no Assembly).

O registrador R13 é normalmente usado como ponteiro de pilha (SP no Assembly). Entretanto, ao contrário de outros processadores, este uso é apenas convenção.

Por último, existe um registrador de status e flags, o CPSR, que é acessível apenas por instruções especiais.

No próximo post começaremos a ver as instruções.

Comemoração

Já decidi como vou comemorar o meu aniversário de casamento este ano: lendo o último livro do Harry Potter. Comprei os dois últimos livros na Livraria Cultura, que entregou no dia do lançamento e por preço compatível com o da Amazon. Vamos ver se eles mantem esta tradição.

Agora só falta acertar com a "patroa"...

terça-feira, janeiro 30, 2007

Vídeos Promocionais do Windows

Com o lançamento do Vista, alguns nostalgistas desenterraram um vídeo promocional do Windows 386 realmente hilário. O vídeo está aqui; a indicação veio do OSNews. Alguns comentários adicionais neste blog.

Aproveito para relembrar um clássico.

sexta-feira, janeiro 26, 2007

Adventure - Parte III

No post anterior tinhamos parado no sucesso obtido pela Sierra com as suas séries de aventuras. Vamos falar agora sobre o principal concorrente da Sierra, que levou ao que poderíamos chamar de "época de ouro" dos jogos de aventura.

Esta empresa surgiu com o nome de LuscaFilm Games e depois passou a se chamar LucasArts. Para os eventuais desligados, o Lucas no nome se refere a George Lucas famoso pelos filmes Star Wars e Indiana Jones. Ele vislumbrou o surgimento dos computadores como uma nova media para o entretedimento e resolveu fincar o pé neste mercado.

Embora a LucasFilm Games tenha gerado jogos de diversos gêneros, seus principais sucessos na década de 90 foram as aventuras. As aventuras da LucasFilm se destacavam a partir dos seus roteiros, muito bem bolados. A implementação contava com gráficos e sons impecáveis, aproveitando os avanços constantes do hardware (vídeos EGA e VGA, placas de som, drive de CD).

O primeiro sucesso foi provavelmente Indiana Jones e a Última Cruzada, baseada no filme. Embora os gráficos e sons ainda fosse toscos no PC, já apresentava uma interface gráfica característica, dispensando a digitação. A aventura seguinte com Indiana Jones foi uma das mais marcantes para mim. Indiana Jones and the Fate of Atlantis possui um rotiro primoroso e inédito (que chegou a ser considerado para um filme). Os gráficos VGA 256 cores e a trilha sonora propriciam a imersão do jogador no ambiente do jogo. A dificuldade dos problemas estava no ponto certo, pelo menos no meu caso.

Uma outra série bem sucedida foi a da Ilha dos Macacos. Em termos de imaginação e roteiro, considero o primeiro jogo da série (The Secret of Monkey Island) o melhor. Com um humor muito refinado, é baseado em uma das atrações dos parques da Disney (como os filmes Piratas do Caribe). O segundo jogo da série (Le Chuck´s Revenge) possui uma quantidade muito maior de ambientes e se encerra com um final estranho e polêmico. O terceiro jogo da série (The Curse of Monkey Island) saiu muito tempo depois e não contou com o produtor original (Ron Gilbert). O estilo gráfico e a interface de operação foram bastante alterados neste terceiro jogo, mas não tanto como no quarto (e até o momento o último) jogo da série. Escape from Monkey Island apresenta gráficos 3D ('Indispensável o Uso de Placa de Vídeo Aceleradora 3D' está em destaque na caixa). O estilo do jogo também mudou e a sequência de luta no final foi muito criticada pelos fans do jogo.

A LucasArts fez um monte de outras aventuras, entre as quais:
  • Loom - uma aventura inovadora mas que não teve sucesso suficiente para ter continuações
  • Manic Mansion e Day of the Tentacle - duas aventuras de Ron Gilbert que não tive a oportunidade de conhecer
  • The Dig - uma aventura de ficção científica, baseada em um roteiro de Steven Spielberg. O jogo é um pouco prejudicado pela instabilidade da plataforma (DOS Extender) e por pistas muito estranhas para os problemas.
  • Sam e Max Hit The Road - uma aventura muito louca, que teve uma continuação cancelada em 2004 pela LucasArts. Os projetistas estão lançando em capítulos um novo jogo com os personagens.
  • Grim Fandango - a primeira aventura da LucasArts em 3D, apesar de ter sido um sucesso com a crítica suas vendas foram consideradas baixas pela LucasArts.
A LucasArts adotou para o desenvolvimento dos jogos um esquema parecido ao da criação de filmes. Se por um lado a qualidade aumentou, o tamanho das equipes e os custos dispararam. Isto significa que os jogos precisavam vender quantidades imensas para dar o esperado 'retorno sobre o investimento'. O resultado foi que a LucasArts foi progressivamente se desenteressando pelas aventuras, preferindo se concentrar em jogos baseados no universo do Star Wars.

Para quem quiser ver a qualidade dos jogos daquilo que chamei de "época de ouro", o site ScummVM é dedicado a um interpretador para os jogos desta época. Além do interpretador, o site contem alguns jogos comerciais completos; Flight of the Amazon Queen é bem representativo dos jogos VGA.

quinta-feira, janeiro 18, 2007

Livros de Dezembro

Embora o tempo estivesse curto para postar, deu para ler alguns livros.

O primeiro foi Fifth Planet, um livro obscuro de Fred e Geoffrey Hoyle. Fred Hoyle foi um astrônomo famoso e autor de um clássico da ficção científica - The Black Cloud. Em Fifth Planet, escrito em conjunto com o filho Geoffrey, aparecem alguns pontos em comum com The Black Cloud: cientistas ganhando espaço no governo, a Inglaterra em destaque no mundo e o contato com uma inteligência extra-terrestre. O livro foi escrito no começo dos anos 60 e a guerra fria tem um certo destaque que hoje soa estranho. No final das contas, uma leitura bem agradável.

Em seguida reli The Dain Curse, de Dashiell Hammett. Hammett é famoso por ser um dos "pais" das histórias de detetive americanas, seu livro mais famoso é o Falcão Maltes. Em The Dain Curse, o detetive (chamado apenas de The Continenal Op), se envolve com uma série de mortes em torno da enigmática Gabrielle Leggett. Uma boa história, com um ótimo final.

Aproveitando o embalo, reli The Thin Man (em português, O Homem Magro), também de Dashiell Hammet. É um livro estranho, a começar pelo Thin Man do título. Embora exista uma semelhança física com o autor e em uma série de televisão baseada no livro tenha associado este nome ao detetive, na história ele é o principal suspeito de um crime e só surge no final (não vou entrar em mais detalhes para não revelar a trama). O detetive é um investigador aposentado, casado com uma mulher muito mais nova. Ambos passam a maior parte do tempo bebendo. A maioria dos personagens são bastante complexos, com comportamentos excêntricos. O livro contem algumas páginas reproduzindo o relato de uma história real de canibalismo que nada tem a ver com mistério.

terça-feira, janeiro 16, 2007

Resoluções de Ano Novo

Até me assustei quando vi a data do post anterior; os motivos para a ausência são os de sempre: trabalho e família.

Para começar um ano, nada como um conjunto de resoluções. Acho que muitos desenvolvedores se identificaram com elas:
  • Instalar e usar um sistema de controle de versão
  • Fazer até o fim pelo menos um dos "programas maravilhosos" que eu invento quando estou longe do micro
  • Aprender direito e usar Python
  • Continuar ignorando Perl e PHP
  • Não trabalhar mais que 60 horas por semana
  • Não ficar 30 dias sem colocar um post no blog

sexta-feira, dezembro 08, 2006

TechEd 2006 - Dia 3

Seguem as impressões sobre as apresentações que eu assisti no terceiro e último dia (30/11/2006) do TechEd 2006.

Smart Client - Composite UI Application Block

Outra palestra bem distante do que eu faço no dia a dia, mas muito boa. O Composite UI Application Block é um dos design patterns implementados pela Microsoft e pode ser baixado gratuitamente daqui. Tirando um pouco do glamour, podemos dizer que é um conjunto de classes para facilitar o desenvolvimento de aplicações de desktop nas quais a janela principal é composta de várias partes relativamente independentes. As classes permitem dinamicamente acrescentar as partes e atualizar o menu e o toolbar. É algo apropriado principalmente para grandes projetos desenvolvidos por times.

A chuva complicou a chegada de muita gente e até um pouco antes da hora prevista só estavam na sala eu e o apresentador (Marcelo Hideaki Azuma). A palestra foi começada com apenas três ouvintes, mas foi rapidamente enchendo (para ajudar uma das palestras ao lado foi cancelada porque o apresentador não chegou a tempo).

Windows Mobile e SQL Mobile - Aumentando a Performance da sua aplicação

Esta foi a palestra que eu menos gostei. Começou com o mal sinal, com o Marcio Boaro desdenhando outras plataformas, e foi morro abaixo. Parecia existir uma divergência entre o que estava escrito no PowerPoint e o que o apresentador tinha entendido. Para tornar um pouco mais divertida a apresentação, estava na platéia o Renato Haddad e pudemos assistir algumas discussões não conclusivas.

Windows Communication Foundation: Integrando aplicações

Uma palestra razoável, mas sem grandes novidades. Uma das poucas em que estourou o tempo.

Segundo o guia do evento, esta palestra ia falar também sobre como usar a solução "pear-to-pear", mas o tempo foi insuficiente. Será que estavam se referindo a isto?

Windows Communication Foundation: Segurança e Gerenciamento com WCF

Uma palestra muito boa, mas sobre a qual estranhamento lembro pouco. Devo confessar que estava meio sonolento... O apresentador foi o Mauro Santana, cuja voz é bem conhecida de quem fez os treinamentos do Programa Cinco Estrelas do MSDN.

Compatibilidade de Aplicações com o Windows Vista

Francamente, não esperava muito desta palestra, mas foi a que mais me marcou.

É inegável que a Microsoft faz um grande esforço para manter compatibilidade entre as versões do Windows, fazendo uma grande quantidade de testes e criando uma série de "adptações técnicas" para contornar programas mal comportados. Por outro lado, algumas decisões, notadamente as relativas a segurança, criam problemas tanto para programas como para usuários.

Uma das novidades do Windows Vista é deixar acessível ao administrador a base de dados de "adaptações técnicas". Este base de dados contém dezenas (centenas?) de aplicações (identificadas por nome do executável e/ou hashes e/ou outras coisas). Para cada aplicação pode ser indicada quais "adaptações técnicas" devem ser aplicadas.

A mais simples destas adaptações é mentir a versão. O Windows Vista é o Windows 6.0; o Windows 2000 é o 5.0 e o Windows XP é o 5.1. Algumas aplicações podem se atrapalhar com isto, seja por paranóia ("Versão de Windows Desconhecida!") ou por erro de programação ("se a versão é 5.1 é XP senão é Windows 2000...").

Uma mudança radical no Windows Vista é o tratamento dado ao Administrador. Na minha opinião, a encrenca toda é consequência da origem do Windows. O Windows surgiu no PC - Personal Computer. Normalmente, quem opera o Windows se considera (com razão ou não) o dono da máquina e espera poder fazer operações que em outros ambientes são de uso restrito, como instalar programas, mudar configurações, etc. O resultado é que quando foram introduzidas proteções, os usuários passaram a trabalhar sempre como administradores. A proliferação dos virus e a retomada do controle da TI sobre os computadores nas empresas grandes e médias criou uma grande encrenca.

A solução proposta pelo Windows Vista é o User Account Control. Basicamente ele tende a rodar as aplicações sob um usuário comum, mesmo se você estiver logado como Administrador. Para rodar uma aplicação realmente como Administrador com o UAC ligado, você precisa clicar com o botão direito e escolher "Run As Administrator". Se você não fizer isto, Coisas Inesperadas poderão acontecer quanto a aplicação tentar fazer uma operação que requer direito de administrador. O Windows poderá pedir uma confirmação, recusar com erro, recusar sem erro ou fazer uma "virtualização". A "virtualização" transforma uma ação que seria global (como escrever em determinados locais do Registry ou salvar uma configuração no Windows.ini) em uma ação restrita ao usuário. É de se esperar muita encrenca e choradeira por conta disto.

Uma coisa ainda mais radical é o Windows Resource Protection. A Microsoft resolveu restringir a atualização dos "recursos protegidos do sistema operacional" (praticamente tudo que está sob o diretório Windows) aos instaladores oficiais (marcados com o certificado digital da Microsoft). Não é mais permitido a um operador ou instalador substituir, modificar ou remover um módulo do sistema. É esperado que isto quebre um monte de instaladores.

Detalhes sobre a compatibilidade de aplicações com o Windows Vista podem ser encontrados aqui.

Concluindo

Valeu a pena? Eu diria que sim, não pelo conteúdo em si (que alguma hora vai estar disponível para download), mas por obrigar a parar por dois dias e meio e olhar outras coisas (ou coisas antigas de forma diferente).

quarta-feira, dezembro 06, 2006

TechEd 2006 - Dia 2

O segundo dia do TechEd 2006 (29/11/2006) começou com uma falha imperdoável que se repetiu no dia seguinte: não foi servido café antes da primeira palestra! O coffee break entre as palestras foi muito bom (principalmente entre a primeira e a segunda do terceiro dia), mas faltou um café para dar ânimo no início do dia (principalmente para quem ainda estava de ressaca do show do dia anterior).

Nesta edição do TechEd existia um número imenso de palestras. No processo de inscrição on-line você selecionava as que pretendia ver. Embora as recepcionistas na porta das salas tivessem um computador de mão (nada menos que o meu amigo SPT-1500, que não usa sistema Windows), ele era usado apenas para registrar as presenças. O controle da inscrição era feito visualmente, conferindo a lista impressa no verso do crachá. Uma vez começada a palestra e sobrando espaço na sala, a entrada ficava livre.

Seguem as minhas impressões sobre as palestras que vi neste dia.

Windows Vista para Desenvolvedores

Apresentou uma visão geral daquilo que um dia foi chamado de WinFx e acabou batizado com o infeliz nome .NET Framework 3.0 (o que merece um comentário mais longo o dia em que eu entender direito).

Desconfio que o marketeiro que definiu o nome dos "pilares" do .NET Framework 3.0 trabalhava antes fazendo press-releases para a Bill & Melinda Gates Foundation, já que todos tem o nome Windows * Foundation, exceto pelo Windows Cardspace, escalado às pressas para substituir o WinFS que não conseguiu ser feito.

Uma palestra boa mas não notável.

Soluções para os mais comuns desafios do Desenvolvimento de Windows Forms

Um segredo não muito oculto é que a Microsoft entregou aos apresentadores as palestras prontas (título, descrição, PowerPoint, exemplos, etc) do evento internacional. Fica difícil quem viu esta palesta do Alfred Myers acreditar isto, já que ele fez um trabalho excelente de adaptação. Cada parte da apresentação era precedida por um post falso do fórum MSDN, que imitava perfeitamente os posts reais (dos nicks estranhos ao estilo do texto).

A palestra em si girou em como contornar alguns "desafios" (bugs e limitações) do Windows Forms. Embora "mais comuns" seja discutível, várias pessoas (inclusive o próprio Alfred) já os tinham enfrentado na vida real. As "soluções" variaram entre derivar uma classe do .NET Framework e substiuir pequenos detalhes a fazer um complexo hook de mensagens para conseguir descobrir quando a visibilidade de um controle muda.

Windows Presentation Foundation: Construindo aplicações ricas e conectadas

O WPF (antigo Avalon) é a parte mais visível do Windows Vista. Esta palestra pode ser resumida ao Times Reader, que é um client para apresentar offline, via WPF, conteúdo do New York Times.

Uma coisa que ficou clara nesta palestra e na próxima, é a dificuldade de integração do WPF ao que já existe (Visual Studio, Windows Forms e mesmo ao SideBar do Vista). Algo que também merece um post mais longo quando eu entender!

Windows Presentation Foundation: Como fazer gráficos 3D na minha aplicação

O Fábio Galuppo seguiu um caminho diferente do Alfred: usou o PowerPoint original, em inglês. O resultado também foi bom, principalmente com a enfase sendo dado ao código.

Quem quiser ter uma idéia de como se programa em 3D com o WPF pode dar uma olhada neste capítulo extra do livro do Petzold sobre WPF.

Melhores Práticas para Criar Web Sites Escaláveis e com Amplo Acesso a Dados

Até hoje fiz muito pouca programação para Web e certamente nada que precisasse atender a número de grande de usuários, mas o título da palestra me interessou. Eurico Brás apresentou uma palestra muito boa sobre os fatores principais para criar sites escaláveis.

Uma curiosidade foi ver a importância prática de algo que mencionei quando falei do gerenciamento de memória no Windows 32 bits. O Windows cria um espaço virtual de 4GBytes para cada processo (o máximo que pode ser endereçado com 32 bits). Deste espaço, normalmente 2G são reservados para o sistema operacional, restando 2G para a aplicação. Normalmente as várias instâncias de um site rodam dentro de um único processo. Uma forma de melhorar o desempenho e eliminar alguns gargálos é usar chaches, o que aumenta o consumo de memória. Devido ao limite de 2GBytes, normalmente não adiante colocar mais que 3GBytes de Ram em um servidor web. No Windows Server 2003 existe uma opção para reduzir o espaço reservado ao sistema para 1GByte, neste caso faz sentido aumentar a memória do servidor até 4GBytes. Mais provavelmente não vai adiantar, pelo menos enquanto não tivermos a infraestrutura ampliada para 64bits (como já foi feito no SQL Server e no Exchange).

terça-feira, dezembro 05, 2006

TechEd 2006 - Dia 1

Segundo a versão oficial, este foi o maior TechEd até agora e incluiu o lançamento da década: Microsoft Windows Vista, 2007 Microsoft Office System e Microsoft Exchange Server 2007.

O processo de inscrição não foi muito suave, como mostram os comentários abaixo:

http://forums.microsoft.com/MSDN-BR/ShowPost.aspx?PostID=722381&SiteID=21
http://forums.microsoft.com/MSDN-BR/ShowPost.aspx?PostID=767777&SiteID=21

O primeiro dia do evento (28/11/2006) foi dedicado às sessões gerais (com algo entre 1700 e 3000 pessoas, dependendo da fonte). Todas estas pessoas ficaram amontoadas no pequeno espaço fora da sala, já que ela só foi aberta no horário de início (ao som de Beautiful Day do U2 repetida seguidamente umas cinco vezes).

Assim que todos se acomodaram, teve o longo lançamento dos três produtos, com Gabriel o Pensador como mestre de cerimônias e um grupo de músicos/dançarinos fazendo performances entre as apresentações. Como parece ser regra nestes casos, o evento estava atrasado uma hora quando veio o coffee-break (que eu não vi, quando eu saí da sala parecia que uma nuvem de gafanhotos tinha passado por ali).

Depois teve uma mais curta (e mais enfadonha) apresentação sobre as comunidades MSDN e TechNet.

Por último, uma apresentação de Hans Donner do seu gadget para o SideBar do Vista, desenvolvido em conjunto com o Fábio Galuppo.

Depois foi só curtir o cocktail do lnçamento e o show do Skank.

segunda-feira, dezembro 04, 2006

Adventure - Parte II

Ao final da primeira parte, o estado-da-arte eram as aventuras ilustradas. Em 1983, a Sierra lançou o que ela chamava de "3-D Animated Adventures".

A tela ao lado mostra o primeiro jogo lançado, o King Quest, em todo o esplendor da CGA com monitor RGB.

Olhando com atenção, é possível ver o nosso personagem, que pode ser movimentado através do teclado. Para realçar o aspecto 3D, o personagem pode passar tanto na frente como atrás de alguns elementos do cenário (como a árvore à esquerda). Os cenários possuiam algumas pequenas animações (como as bandeiras do castelo) .

Os comandos para interagir com o cenário continuavam sendo digitados, porém o parser era mais simples que o usado pela Infocom, a enfase claramente era na parte gráfica.

Estas aventuras tiveram grande sucesso e acabaram criando várias séries, como King Quest, Space Quest e Leisure Suit Larry. Para quem quiser ver como era um jogo da época, existe um jogo da série Space Quest feito por um fã: The Lost Chapter. Os primeiros jogos da série King Quest foram refeitos por fãs, com gráficos e sons atuais: King Quest I, King Quest II e King Quest III.

Como as demais aventuras, estas se baseavam em um interpretador, o AGI. Posteriormente a Sierra criou um aegundo interpretador, o SCI. À medida em que a resolução e o número de cores ia aumentando, a interface foi se afastando da digitação de texto e se limitando ao point-and-click. Nos links acima existem tanto interpretadores como editores de jogos.

Um Ano de Vida

Sábado passado (2/dez) este blog completou um ano de vida! Foram 75 posts, uma quantidade bem razoável. Idéias e rascunhos de novos posts não faltam, o que tem faltado é tempo!

Segundo o StatCounter, um número razoável de pessoas esbarram neste blog, alguns até intencionalmente. Espero que tenham encontrado algo de útil!

terça-feira, novembro 21, 2006

Resultado improvável no Google

Uma das informações curiosas fornecidas pelo StatCounter é o "Come From" que mostra a página anterior. Tipicamente é uma consulta ao Google, o divertido é ver o que foi procurado e qual o ranking da minha página nos resultados.

Um fato surpreendente foi ver que apareci no topo* para a busca de testes dos setes erros que aparecem diabos . Não é tão bacana quanto ser o especialista em placenta baixa, mas deu para dar algumas risadas.

* Como tudo na Web, isto é temporário. Provavelmente esta página vai mudar o resultado.


quinta-feira, novembro 16, 2006

O Longo Adeus ao Symbol Palm Terminal

Já esperada há alguns anos, saiu finalmente a notícia do encerramento da fabricação e venda da família SPT. Ainda tenho as pastas que eu montei em 1998, quando foi anunciado o SPT-1500 e tomei contato com a plataforma Palm. De lá até uns dois anos atrás, muito do meu trabalho envolvia esta plataforma. Aliás, foi só eu começar a escrever este post para vendermos mais umas cópias de um software feito para o SPT.

A Família SPT

A Symbol é um dos principais fabricantes de leitores de código de barras (scanners) e coletores portáteis de dados. Em 98 ela teve a idéia de criar um coletor baseado no recem lançado Palm III, que estava finalmente criando a categoria de Personal Digital Assistent (PDA), após alguns fracassos notáveis como o Newton da Apple.

O SPT-1500 consistia no hardware do Palm III (a mesma placa) acrescentado de um leitor de código de barras. Embora as características de hardware pareçam modestas nos dias de hoje (processador de 16 bits operando a 8MHz, 2MBytes de Ram, baterias não recarregáveis) o SPT-1500 possuia desempenho suficiente e um bom leitor de código de barras para aplicações de coletas de dados em um formato pequeno e leve e por um preço baixo (para o mercado de coletores de dados). A principal restrição do SPT-1500 era a baixa robustez; a solução da Symbol foi uma capa de borracha especial. O SPT-1500 era atraente principalmente para os mercados mais sensíveis a preço, como o brasileiro.

No ano seguinte foi lançado o SPT-1700, que era um reprojeto do hardware para obter a robustez esperada de um coletor (resistência a quedas de até 1,2m e operação de -20 a 50 graus C). Além disso, a linha SPT-17xx incluia modelos com rádio padrão 802.11 e CDPD.

Alguns anos mais tarde o SPT-1500 e os SPT-17xx foram substituídos pelos SPT-1550 e SPT-18xx, que utilizam processadores um pouco mais rápidos e uma versão mais recente do PalmOS

A Ascenção e Queda da Plataforma Palm

Após uma tentativa mal-sucedida em conjunto com a Casio, a Palm Computing lançou em 96 os primeiros modelos, chamados de Pilot 500 e Pilot 1000. No ano seguinte foram lançados o PalmPilot Personal e o PalmPilot Professional (que dispunha de um stack TCP/IP para uso com modem). Em 98 foi lançado o Palm III (as mudanças no nome se devem a um processo da empresa Pilot que fabrica canetas).

O Palm III acrescentou uma interface infra-vermelha e foi um grande sucesso. Os motivos principais foram o formato, a resposta rápida, uma grande facilidade de operação, um reconhecimento de escrita confiável, um esquema de sincronismo com PC quase que transparente, uma imensa autonomia com baterias palito e um imensa quantidade de softwares.

A plataforma Palm usa o seu próprio sistema operacional, o PalmOS. O objetivo original era ter um sistema compacto e eficiente. Por exemplo, a função de leitura de arquivos (databases na terminologia da Palm) retorna um ponteiro para a posição da Ram onde o registro está e o código dos programas era executado diretamente na posição onde estava armazenado. A parte da memória onde ficam os databases é protegida pelo hardware, evitando que um ponteiro perdido os danifique. Aliás, o PalmOS era extremamente robusto e mensagens de erro e reset era raro para quem usava apenas as aplicações pré-instaladas (para quem desenvolvia era um pouco diferente, mas acho que nunca me ocorreu de perder um database). A maior parte das funções do PalmOS eram de manipulação da interface com o usuário. O núcleo em si do sistema foi licenciado de outra empresa. Embora este núcleo fosse multi-tarefa, o contrato impedia a Palm de expor para as aplicações as funções de manipulação de tarefas (ou seja, a aplicação era composta de uma única tarefa).

Uma das minhas surpresas ao aprender a programar para o PalmOS foi descobrir o que acontecia quando se chaveava de uma aplicação para outra: a aplicação anterior encerrava e a nova era executada. Cabia à aplicação salvar o seu contexto e restaurá-lo para dar uma experiência semelhante ao Alt Tab no Windows. Apesar disto, o chaveamento era muito rápido.

Do ponto de vista da interface com o usuário, a Palm sempre considerou que as soluções usadas no desktop não são apropriadas para os equipamentos portáteis, com telas pequenas e operados com uma caneta. Por exemplo, não existe o "duplo tap" e as aplicações (e a maioria das janelas) sempre ocupam toda a tela.

Tentando evitar a situação da Apple com o Mac, a Palm licenciou o PalmOS para outras empresas, como Sony, Samsung e Symbol. Estas empresas tinham grande liberdade para alterar a plataforma, criando produtos bastante diferenciados.

A Microsoft concorreu com a Palm desde quase o início, porém sua linha foi outra. Ao invés de um sistema compacto, investiu em um sistema mais completo que suportasse um subconjunto da API do Windows. A Microsoft especificou em detalhes a plataforma, não permitindo grandes variações entre os produtos. A primeira geração, chamada de Palm-sized PC, sofria para rodar em um processador RISC a 133MHz com 16M de Ram. Era comum você ver a tela se desenhar aos poucos. A bateria durava poucos dias. A interface com o operador tentava seguir o padrão do Windows no desktop (e até hoje se usa o "duplo tap").

Mais uma vez a Microsoft apostava suas fichas na Lei de Moore. Animada com o sucesso, a Palm acabou apostando contra. Por exemplo, a Microsoft adotou cedo as telas coloridas, a Palm insistia em que eram inúteis e que consumiam muita bateria. Em 2000 a Microsoft lançou o Pocket PC e encostou. Vieram depois o Pocket PC 2002 e o Windows Mobile. No lado do hardware veio o StrongArm e os 64M de Ram.

A Palm teve também uma história turbulenta como empresa. Antes de conseguir o sucesso com o Palm III os fundadores a venderam para a U.S. Robotics (por falta de recursos financeiros), que logo depois foi comprada pela 3Com. Embora tudo parecesse maravilhoso, os fundadores sairam da Palm para criar uma outra empresa, a Handspring, que licenciou o PalmOS e passou a competir com a Palm. Mais adiante a 3Com decidiu separar a Palm, que posteriormente se desmembrou em uma empresa de hardware e uma empresa de software (PalmSource). A empresa de hardware veio a se juntar à Handspring, com o nome de PalmOne.

Durante todas estas mudanças coorporativas, o PalmOS pouco avançou. O Palm III utilizava o PalmOS 3. A versão 4 tentou unificar os vários aperfeiçoamentos criados independentemente pelos licenciados. Pelo menos duas tentativas de criar um novo sistema fracassaram. A primeira não chegou a ser liberada e nenhuma equipamento foi produzido com a segunda. Pressionada pela falta de competitividade do processador original, a PalmSource seguiu o caminho do Mac e migrou para uma plataforma RISC emulando por software o processador original (com muito sucesso). Os equipamentos PalmOS atualmente em produção utilizam esta versão.

Finalmente, no final de 2005, a PalmSource foi comprada por uma empresa japonesa (Access). Algum tempo depois foi anunciado o fim do PalmOS como sistema operacional: os esforços agora para colocar a interface do PalmOS sobre um núcleo baseado no Linux. A PalmOne voltou a ser Palm e tem concentrado os novos desenvolvimentos em smartphones, inclusive modelos usando Windows CE.

É uma pena, pois a Palm era uma grande empresa, criou produtos inovadores e a concorrência com a Microsoft foi certamente benéfica para os usuários.

quarta-feira, novembro 08, 2006

Adventure - Parte I


Neste post vou começar a falar sobre um tipo de jogo que aprecio muito: Adventure. Este tipo de jogo é às vezes chamado de Ficção Interativa, pois o objetivo principal é contar uma história de forma interativa, com o jogador controlando um personagem.

Ao longo do post menciono varios sites onde alguns jogos podem ser baixados legalmente.

Colossal Cave Adventure - A Aventura Original

O primeiro jogo deste tipo foi criado em Fortran, em um minicomputador PDP. A história completa de porque e como este jogo foi criado pode ser encontrada aqui.

O formato usado foi o padrão por muito tempo. A interface é toda em texto, com o jogador digitando comandos, tipicamente na forma . O jogador passeia entre locais (salas no jargão dos desenvolvedores e fãs), recolhendo e usando objetos. Existe um objetivo (no caso, existem tarefas e tesouros que dão pontos ao jogador) e diversos problemas a serem resolvidos (tipicamente usando os objetos recolhidos). Concluir o jogo (isto é, resolver todos os problemas) é normalmente uma tarefa de dias ou semanas.

A Aventura Original foi migrada, adaptada, re-escrita e aperfeiçoada diversas vezes. Até mesmo a Microsoft chegou a comercializar uma versão, na época do lançamento do IBM PC. Uma adaptação direta da original, em Fortran, pode ser baixada daqui. Donald Knuth escreveu uma adaptação em C, usando um sistema de documentação a partir do fonte desenvolvida por ele; ela pode ser baixada aqui.

Adventure International - A Aventura Chega aos Micros Pessoais

Scott Adams (não confundir com o homônimo que é o autor do Dilbert) foi quem primeiro transportou este tipo de jogo para os micros pessoais. Para colocar o jogo em micros com 16K de memória (e que usavam fita cassete para armazenamento), Scott usou descrições curtas, limitou o vocabulário e, mais importante, criou um interpretador de aventuras. A aventura propriamente dita eram os dados processados pelo interpretador. Por exemplo, existiam as listas de verbos e objetos. Uma tabela relacionava combinações de verbos, objetos e condições com ações a serem executadas. Por exemplo, se o jogador digitar ACENDER FOSFORO e a DINAMITE estiver na sala atual deve ser executa da ação "perde o jogo".

No site do Scott Adams exitem links para baixar as aventuras que ele comercializou. Uma delas é a Pirate Adventure, cujo código foi publicado na revista Byte e eu penei para converter em Cobol e rodar no computador a que eu tinha acesso.

Para quem for fluente em inglês, tem uma entrevista do Scott Adams para baixar em MP3 aqui. Particularmente divertida é a parte em que ele joga uma aventura com a plateia.

Infocom - O Auge da Aventura em Texto

Pode ser surpresa, mas uma das principais empresas de jogos no começo dos micros pessoais desenvolvia apenas aventuras em texto. A história completa pode ser vista aqui e aqui. Basicamente foi um bando de amigos que pretendiam fazer um software "sério" mas que como primeiro produto resolveram lançar um jogo que tinham feito na faculdade - assim surgiu o Zork (mais especificamente Zork I, Zork II e Zork III, pois o jogo teve que ser quebrado para caber nos micros).

Os jogos da Infocom se caracterizavam por descrições longas e caprichadas e uma grande capacidade de interpretar os comandos do jogador. No lugar de , o parser aceitava frases completas. Como Scott Adams, a Infocom também utilizava um interpretador, os jogos eram escritos para uma máquina virtual chamada Z-Machine.

Uma outra característica dos jogos da Infocom foram as embalagens e complementos sofisticados. Além de ajudarem na imersão no jogo, isto dificultava e tornava menos atraente a pirataria.

Os jogos Zork I, II e III podem ser baixados aqui.

Os Fãs das Aventuras de Texto

Embora as aventuras de texto não sejam mais comercializadas, ainda existem algumas legiões de fãs na Internet. Entre as suas criações, existem ambientes para desenvolvimento de aventuras, como o Inform, e interpretadores para formatos populares como a Z-Machine e o usado por Scott Adams.

Existe até um concurso anual. Entretanto, a regra do concurso é que o jogo deve ser avaliado após jogar por duas horas, portanto são normalmente jogos curtos.

As Aventuras Ilustradas

Um recurso que surgiu bem cedo foi substituir as descrições dos locais por imagens estáticas. A Sierra (vamos falar mais sobre ela) fez várias aventuras assim para o Apple II.

Mesmo no tempo dos PCs com placas EGA e Soundblaster ainda existiam aventuras deste tipo. Uma delas é Gateway, baseada no livro de ficção científica de mesmo nome. A versão que eu tenho em casa foi baixada do site da editora (Legend Entertainment), onde o jogo estava disponível gratuitamente para download para promover a venda de uma coletânea de jogos antigos. Infelizmente, a Legend fechou e portanto o site não existe mais. O jogo pode ser encontrado em sites de Abandonware, porém a legalidade destes downloads é discutível.

Gerenciamento de Memória - Bibliografia

Aqui está a lista dos livros que consultei ao escrever os posts sobre Gerenciamento de Memória. São todos livros antigos e em inglês.

Gates - Stephen Manes e Paul Andrews - Ed Touchstone 1994
Biografia de William Henry Gates III, conhecido por todos como Bill Gates. Um livro fascinante de onde extraí não somente detalhes históricos mas também alguns detalhes técnicos. Ainda disponível na Amazon.

The 80386/387 Architecture - Stephen Morse, Eric Isaacson e Douglas Albert - Ed Wiley, 1987
Uma descrição completa do processador 386 e do co-processador 387. A Ed Campus publicou uma tradução em 1989 (o tardutor foi um tal de Daniel Quadros...)

DOS 6 A Developer's Guide - Al Williams - M&T Books, 1993
Um livro incrivelmente completo sobre o DOS, da época em que o DOS estava chegando ao final. Inclui até os fontes de um pequeno DOS Extender.

Programming Windows 3.1 - Charles Petzold - Microsoft Press, 1992
Nos tempos do Windows 16 bits, se você queria programar para Windows, tinha que ler os livros do Petzold.

Advanced Windows Third Edition - Jeffrey Richter - Microsoft Press, 1997
O complemento perfeito para os livros do Petzold sobre Win32, foca em Processos, Memória e I/O.

segunda-feira, novembro 06, 2006

DVD: Rick Wakeman The Legend (Live in Concert 2000)

Como já mencionei alguma vez, sou fã do chamado "rock progressivo". Minha juventude foi particularmente marcada pelas obras de Rick Wakeman. Além de gostar das músicas, tinha a vantagem de não expulsar o meu pai da sala :)

Dando uma olhada nas prateleiras de uma Livraria Saraiva, encontrei o DVD "Rick Wakeman The Legend" e acabei comprando. Já tinha outros DVDs dele, mas este tem algumas diferenças:
  • é um show solo, sem acompanhamento de banda (na maioria das músicas tem um discreto acompanhamento em playback);
  • embora o palco tenha vários teclados, ele se concentra em apenas um ou dois em cada música e evita os sons mais radicais (desta vez não usa o minimoog);
  • o repertório é bastante variado, incluindo alguns sucessos óbvios (extraído de As Seis Esposas de Henrique VIII, Viagem ao Centro da Terra e Mitos e Lendas do Rei Arthur), algumas músicas do Yes e algumas peças clássicas (Cannon in D e Clair de Lune); e
  • além das músicas, inclui algumas das famosas histórias que ele costuma contar durante o show. A da única vez em que ele esteve bêbado no palco é impagável!
O resultado é um show fantástico que destaca a técnica e a capacidade de interpretação de Rick Wakeman.

O DVD inclui ainda mais algumas músicas gravadas em estúdio, somente em audio.

É o melhor de tudo é que o preço é razoável (paguei R$19,90 na loja, na internet está por R$18,90 mais o frete).

Gerenciamento de Memória - Windows 32 bits

Como vimos na parte anterior, a versão 3 do Windows 16 bits finalmente levou os programas ao modo protegido dos processadores x86. Não era, porém, a única opção que a Microsoft fornecia para isto: existia também o OS/2, um gigantesco projeto conjunto com a IBM.

O desenvolvimento do OS/2 foi marcado principalmente pelas diferenças entre a Microsoft e a IBM, em termos de concepção do produto e forma de trabalhar. Esta tensão chegou ao limite após o lançamento da versão 3 do Windows, o que levou a uma separação entre as duas empresas. Esta separação deixou com a Microsoft o que a IBM chamava OS/2 3.0.

Este projeto, iniciado em 1988, era comandado por David Cutler (que tinha larga experiência no projeto de sistemas operacionais adquirida na DEC) sob o nome de NT - New Technoly. No começo de 1991, era anunciado o desenvolvimento do Windows NT e a expansão da interface de programação do Windows de 16 para 32 bits - o Win32. O Windows NT só veio a ser lançado na metade de 93 e teve um aceitação lenta (em parte por exigir a extravagância de 16 Megabytes de Ram, numa das raras ocasiões em que o preço da memória estava subindo ao invés de descer).

Uma das características do NT era a independência do processador utilizado, inicialmente o NT estava disponível não somente para o x86 mas também para processadores RISC como MIPS, Alpha e POWER. Isto influenciou algumas decisões na parte de gerenciamento de memória.

Enquanto que o Windows NT foi escrito praticamente a partir do zero, uma outra implementação do Win32 foi feita a partir do Windows 16 bits, criando o Windows 95.

Para tentar ajudar a migração aos 32 bits, existia uma "adaptação técnica" que implementava um subconjunto do Win32 sobre o Windows 16 bits - o chamado Win32s. Para os fins deste post vamos ignorar o Win32s.

O Mapa da Memória

No Win32 os recursos de gerenciamento de memória do processador são usados para dar a cada processo o seu próprio espaço de endereçamento com 4GB (é claro que a maior parte desde espaço normalmente não tem memória física associada).


No Windows 9x (95, 98 e Me), os 4GB são divididos da seguinte forma:
  • os primeiros 4M (endereços 0x00000000 a 0x003FFFFF) são reservados para o sistema operacional (DOS e Windows 16 bits) e não devem ser acessados pelas aplicações (porém apenas os primeiros 4K estão protegidos)
  • os bytes seguintes até a metade do espaço de endereçamento (0x00400000 a 0x7FFFFFFF) estão diponíveis para o processo. Esta memória é privada ao processo; outros processos não podem acesssá-la.
  • em seguida existe 1G (de 0x80000000 a 0xBFFFFFFF) de endereçamento compartilhado por todos os processos. É nesta região que são colocados os arquivos mapeados em memória e DLLs compartilhadas.
  • O último gigabyte (0xC0000000 a 0xFFFFFFFF) contém o sistema operacional e não deve ser acessado pelas aplicações (porém não está protegido e é compartilhado por todos os processos)
Portanto, embora o Windows 9x protega as aplicações entre elas, ele não protege o sistema operacional em si.

No Windows NT (e 2000 e XP), os 4GB são divididos um pouco diferente:
  • os primeiros 64K (0x00000000 a 0x0000FFFF) são inacessíveis, para facilitar a detecção de ponteiros inválidos (tipicamente com NULL).
  • de 0x00010000 a 0x7FFEFFFF (2G - 128K) fica a região privada do processo. Ela é usada para o código e dados do processo, os arquivos mapeados em memória e as DLLs.
  • os 64K no final da primeira metade (0x7FFF0000 a 0x7FFFFFFF) são inacessíveis, para facilitar a detecção de ponteiros inválidos.
  • os dois últimos gigabytes (0x80000000 a 0xFFFFFFFF) contém o sistema operacional e não podem ser acessados pela aplicação.
Portanto o Windows NT é extremamente rigoros em termos de separação entre os processos e de proteção da memória ocupada pelo sistema operacional.

Usando o Espaço de Endereçamento

Quando um processo é criado, a maior parte do seu espaço de endereçamento é marcada como livre. Uma tentativa de acessar um destes endereços causará um erro.

O primeiro passo apra usar a memória é alocar uma região usando a função VirtualAlloc. A alocação não associa memória física à região, apenas a marca como em uso. O endereço inicial da região deve ser múltiplo da granularidade de alocação (64KB) e o tamanho deve ser múltiplo do tamanho da página do mecanismo de memória virtual (o que varia conforme o processador). A função VirtualFree libera uma região.

O passo seguinte é associar memória às páginas da região (commit). O Commit é controlado no nível de página, portanto não é necessário associar todas as páginas da região de uma só vez. O commit é feito também pela VirtualAlloc; VirtualFree pode ser usada para cancelar o commit liberando a memória. A memória associda não corresponde necessáriamente a RAM física, o Win32 utiliza os recursos de memória virtual do processador para controlar a movimentação das páginas entre a Ram e o disco (arquivo de paginação), simulando uma memória Ram maior que a real se necessário.

Arquivos Mapeados na Memória

O mesmo recurso que é usado para simular uma memória Ram maior que a real, através da movimentação de páginas entre a Ram e o arquivo de paginação pode ser usado com arquivos comuns.

O resultado são arquivos mapeados em memória: do ponto de vista do programador é como se todo o arquivo tivesse sido carregado para a memória, ficando acessível via ponteiros ao invés de funções de acesso a arquivo. Isto é usado no Win32 de três formas principais:

  • para carregar e executar arquivos EXE e DLL. Desta forma a paginação do código é feita diretamente entre a Ram e o arquivo original, não envolvendo o arquivo de paginação.
  • para simplificar o acesso a dados em um arquivo. O programa manipula o arquivo através de ponteiros sem precisar se preocupar em chamar as funções de acesso a arquivo ou gerenciar buffers de leitura e escrita.
  • como forma de compartilhamento de dados e inter-comunicação entre processos rodando em uma máquina. Dois ou mais processos podem mapear em memória o mesmo arquivo, desta forma as alterações feitas por um são visíveis a todos.

segunda-feira, outubro 30, 2006

Livro do Mês: The End

Meros 12 dias após sair da Amazon, chegou em minhas mãos The End. As resenhas na Amazon tem oscilado fortemente entre os que adoraram e os que detestaram o livro.

As críticas principais tem a ver com a falta de resposta a vários mistérios e ao final inconclusivo da história. Na minha opinião, quem leu os livros anteriores não devia esperar coisa diferente. O livro "Lemony Snicket: The Unauthorized Biography" já era bem emblemático: cada capítulo tinha como título uma pergunta frequente, riscada pelo autor e substituída por uma pergunta mais estranha e misteriosa.

O livro aborda diretamente estes questionamentos. Na parte das respostas, diz que muitas respostas são irrelevantes e que toda resposta traz mais perguntas. E algumas respostas importantes estão lá, mas nunca de forma direta. Com relação a um final inconclusivo, Lemony Snicket é categórico: é impossível contar "Toda a História". Existem infinitas histórias entrelaçadas e é tolice falar em início em fim. Daí, parar a história num ponto apropriado qualquer é o melhor que se pode esperar.

A trama em si do livro é muito boa. Novamente os Bauldelaires estão em algum lugar estranho, cercados de personagens únicos. É possível enxergar vários simbolismos para os acontecimentos, com conclusões conflitantes. E tem o clímax com a morte de dois personagens (que traz mais um imenso mistério não respondido).

E assim chegamos ao fim. Ou não.

terça-feira, outubro 24, 2006

Gerenciamento de Memória - Windows 16 bits

O início da história das interfaces gráficas com o usuário (GUIs) é provavelmente o computador Alto, demonstrado pela Xerox em 1973 e nunca lançado comercialmente. O Alto, e o seu sucessor o Star, foram desenvolvidos por um centro de pesquisa da Xerox chamado PARC.

Em 1980, algumas semanas antes da Microsoft fechar as negociações do DOS com a IBM, um dos desenvolvedores da Xerox bateu na porta da Microsoft. Era Charles Simonyi, um húngaro que tinha desenvolvido o processador de textos do Alto, provavelmente o primeiro editor "WYSIYWYG". Alguns meses depois ele estava contratado como diretor de desenvolvimento de produtos avançados, se dedicando inicialmente ao desenvolvimento do tipo de aplicações que atualmente chamamos de Office (planilha eletrônica, editor de texto, etc).

As idéias da PARC corriam soltas na nascente indústria de microcomputadores. Na Apple, geraram o Lisa e depois o Mac. Na Comdex de 1982 Bill Gates levou um susto com um produto chamado VisiOn. Desenvolvido pela empresa responsável pelo VisiCalc (a primeira planilha eletrônica), o VisiOn era um pacote de aplições completo com interface gráfica, rodando no PC. A única boa notícia é que o produto ainda não estava pronto. Ao longo de 1983 diversos outros sistemas gráficos e multitarefa foram anunciados.

A resposta da Microsoft chamava-se inicialmente Interface Manager. Na Comdex de 1983 já estava rebatizado para Microsoft Windows e era objeto de uma campanha de marketing sem precedentes. Após várias mudanças de curso e uma negociação em cima da hora com a Apple, o Windows foi finalmente lançado na Comdex de 1985. Embora as primeiras notícias tenham sido favoráveis, testes mais completos revelaram um sistema lento, com suporte limitado a periféricos e com uma ausência quase total de aplicativos.

A primeira versão do Windows sofria com um processador sem a capacidade necessária, com placas de vídeo extremamente limitada e, o que aqui nos interessa mais, da falta de recursos de hardware para gerenciamento de memória.

Windows 1

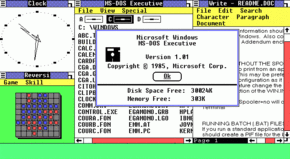
Do ponto de vista visual, o Windows 1 tinha uma grande diferença em relação a todas as versões seguintes: não apresentava janelas sobrepostas.

Do ponto de vista de memória, o Windows 1 suportava apenas os até 640K de memória convencional do 8088 e 286. Entretanto, já apresentava uma série de recursos avançados:
  • Ao executar múltiplas instâncias de um mesmo programa, era usada um única cópia em memória do código e dos resources.
  • Grande parte das áreas de memória alocada através do windows podiam ser movidas, para agrupar as áreas livres criando blocos contíguos maiores ou para permitir expandir o tamanho de uma área alocada anteriormente.
  • Segmentos de código e resources eram normalmente carregados sob demanda, só sendo trazidos para memória quando necessários.
  • Os segmentos de código e resources eram normalmente descartáveis, podendo ser retirados temporariamente da memória (e posteriormente recarregados a partir do .EXE) para liberar memória.
Desta forma, o Windows 1 já era capaz de rodar "simultaneamente" vários programas que ocupavam junto mais memória que a disponível fisicamente. Entretanto, isto requeria acessos frequentes ao disco, com consequente queda de performance.

Windows 2

A principal alteração no Windows 2 foi o suporte a janelas sobrepostas e melhoramentos na parte visual (o que causou uma disputa judicial com a Apple).

Do ponto de vista de memória, a novidade foi a adição de suporte à memória expandida (LIM EMS).

A Microsoft criou também uma versão específica para o 386 (Windows386), que implementava memória expandida na memória extendida e usada o modo 8086 virtual para suportar múltiplas janelas DOS. O Windows e as aplicações continuavam rodando no modo real tanto no 286 como no 386.

Windows 3

A terceira versão finalmente suportou o modo protegido. A mágica foi feita pela iniciativa isolada de um programador, num momento em que a Microsoft estava concentrada no OS/2.

Do ponto de vista visual, o Windows 3 apresentava alguns efeitos simples de "3D".

O Program Manager e o File Manager substituiam o "MS-DOS Executive", fornecendo uma interface mais gráfica para disparar programas e manipular arquivos.

O Windows 3 era capaz de operar em três modos:
  • real mode: da mesma forma que o Windows 2, suporta o 8088 e 286/386 com pouca memória. Largamente ignorado por desenvolvedores e usuários e abandonado na versão 3.1.
  • standard mode: para máquinas com um 286 e 1M de Ram ou mais (ou máquinas com 386 e menos de 2M de Ram), usa o modo protegido do 286.
  • 386 enhanced mode: além de usar o modo protegido do 286, utiliza dois recursos do 386: paginação (para implementar memória virtual) e o modo 8086 virtual (para suportar múltiplas janelas DOS).
Organização da Memória no Windows 16 bits

A memória gerenciada pelo Windows é chamada de "memória global" ou "global heap" (global no sentido de total) e vai do ponto onde o Windows foi carregado pelo DOS até o fim da memória disponível.

O Windows 16 bits utiliza segmentos de até 64K. Cada bloco alocado da memória global é um segmento. Um programa possui um ou mais segmentos de código e um ou mais segmentos de dados. O Windows cria dois segmentos adicionais para cada um programa, um compartilhado por todas as instâncias e outro único para cada instância. Os resources são também carregados em segmentos.

Normalmente os segmentos são considerados movíveis. No modo real, quando um segmento se move, os ponteiros far (aqueles que incluem segmento e offset) precisam ser ajustados. No modo protegido, o Windows precisa apenas alterar o descritor do segmento e os ponteiros far continuam válidos. Um segmento pode ser marcado como fixo, mas isto irá atrapalhar o gerenciamento de memória, criando "buracos" na memória livre.

Para permitir a movimentação de segmentos no modo real, o Windows utiliza com frequência handles ao invés de endereços. Os handles são índices ou offsets para tabelas que contém o endereço real. Quando um segmento é movido, apenas as tabelas precisam ser atualizadas. Ao alocar memória (usando a rotina GlobalAlloc) um programa recebe um handle. Para acessar a memória, o segmento é temporariamente fixado e convertido em um endereço (usando GlobalLock), o acesso é feito e a memória é desbloqueada (usando GlobalUnlock). Para causar o mínimo impacto ao sistema, a memória deve ficar fixa somente enquanto uma mensagem de janela é tratada.

Uma outra consequência das limitações do modo real, é que um programa só pode conter inicialmente um segmento de dados movível, os demais serão fixos. Isto ocorre porque o Windows não tem como interferir com o código gerado pelo compilador para acessar dados em outros segmentos. Na prática, os programas tinham apenas um segmento de dados e criavam os outros dinamicamente (usando GlobalAlloc).

O resumo de tudo isto é que era muito complicado fazer programas no Windows 1 e 2 (ou no modo real do Windows 3) que precisassem de bastante memória.

No lado do código as coisas eram melhores, com o Windows suportando múltiplos segmentos de forma transparente (porém ao custo de desempenho). Aliás, era uma estratégia frequente quebrar programas em um número absurdo de pequenos segmentos (por exemplo, o programa Write que era incluído no Windows tinha 220K de código distribuído em 83 segmentos de código, todos movíveis e descartáveis e nenhum deles com mais de 10K). Desta forma, o Windows conseguia rodar (ou melhor, engatinhar) mesmo em um 8088 com memória bastante restrita.

A passagem para o modo protegido deixou para trás a maior parte destas preocupações. As poucas que sobraram foram embora com a passagem para os 32 bits, com o Windows NT e o Window 95.